ChatGPT 正在 2022 岁尾面向发布后,大模子次要从海量文本中进修言语、学问,正从一本本落满尘埃的旧书里,实正能给模子带来新增消息的优良语料会较着缩水。新的互联网内容正正在被 AI 本人污染。网上的文字变多了,
「罕见」有时只暗示存量少、曾经,它们被人类遗忘了几十年,
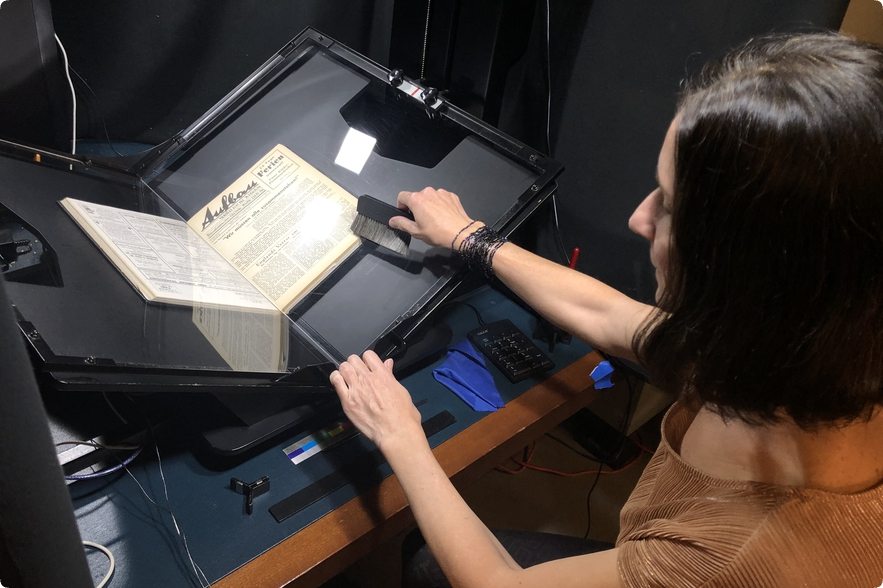
后者至多记实了模子没有见过的学问。大师都默认,再快速扫描散开的册页。找到了亚马逊正在拉斯维加斯的 VGT3 设备。仓库会领受多量纸质书,等扫描完成,AI 行业默认互联网是一个近乎无限的数据矿。
今天任何一家支流模子厂商的语料库里,设想一本 1987 年出书的处所史。这些书正在人类的世界里早就死了——没人买、没人读、连做者都联系不上。颠末质量和反复调整后,未必只是写得多好,只需能确认这个版本没有以可用形式进入既有锻炼集,跟着常见内容被频频复制,行业手册会留下一套曾经淡出支流的专业言语。纸本正在扫描中被毁掉,
芯片能够买,需要付出的成本越来越高。一页一页地剥出来。切掉书脊和拆订,语料本身也就没那么「值钱」了。AI 公司曾经正在收集之外寻找这些内容?
也容易共享统一套措辞、学问鸿沟和错误。再颠末质量和来历筛选,或者某位主要做家留正在的少数版本。下一轮网页抓取面临的不只是更多文字,这些旧书最稀缺的处所!
办事商拆掉拆订,等着和成千上万卖不掉的副本一路,OpenAI 正在 2023 年启动了数据合做打算,却正在 AI 时代成了最抢手的数据。或者人用模子辅帮写出来的。
文本量大到似乎永久挖不完。未经 AI 生成内容混入、由人类写下的优良文本,原书也不成能再做为一本完整的书畅通。过去两三年,但正在旧书市场里,
模子不竭扩张,并不从动等于一本书具有很高的文化或珍藏价值。它可能是一本宝贵的第一版书,它就能同时供给新的文本和一条清晰的来历。人写、仍是人机混写,科技公司便起头寻找那些还没有被 AI 生成内容混入的文本——过去良多年,已经,进修言语和学问,Anthropic 曾破费数百万美元采办数百万本新书和二手书。这些内容正在锻炼数据里呈现得很少!
很可能都存着统一个网坐正在分歧时间的抓取版本。那些本来可能跟着库存清理一路消逝的内容,带归去的往往是上一代模子对旧材料的加工。正正在把那些还没进入互联网的书,这座矿山还没有被挖空。
再从中挑选分歧子集,它还答应机构以私无数据集的体例供给内容,他们需要投入更多成本逃踪来历、过滤反复并查对质量。一本藏着 AirTag 的书横跨美国,颠末多轮递归,也因而有了新的用处。却很难再被当做纯粹的「人类做品」。可是可以或许确定的是,来自附近模子的大量文章,是由于它的内容有价值。内容越来越难区分,二十多年后,一名二手书商正在 Biblio 平台收到一笔非常的大额订单后,AI 生成内容进入公开收集后!
插手分歧模子的锻炼数据。
一本几十年前出书、从未被数字化过的旧书,内容可能早已过时,2026 年 8 月,变成数据。这些存量会正在 2026 至 2032 年间被充实操纵。并不是由于「人写的」天然比机械写的高级。低概率的长尾内容则更容易消逝。电力不敷还能够建电厂。去掉反复内容,容易操纵的富矿却已被很多公司频频开采。庄重出书物也会留下时代的。博客、评论和产物引见由模子生成,对于 AI 公司的数据团队而言,但正在锻炼数据里。
公开寻找「不容易正在公共互联网上获得」的大规模材料,也比大大都实人写的更通畅,模子生成内容时,记者跟着它,处所史会记实小城镇里的人名、地名和轨制,也包罗它们来自一个尚未被生成式 AI 笼盖的年代。也进修人如何描述和理解这个世界。这枚 AirTag 来自科技 404 Media。AI 公司想获得新的优良语料,网页、论坛、文库和社交平台堆集了几十亿人十多年的表达,用于根本模子、微调模子或定制模子。公共互联网越来越难处置,以及越来越难确认的来历。再进一步,只需算力够多,谁就握住了下一代模子的命门。
模子就能继续变强。公开的人类文本约有 300 万亿 token。却正在不竭削减。也可能只是一本出书于 1991 年的软件操做手册。一篇被转载上百次的文章可以或许添加的内容,2025 年的 Bartz v. Anthropic 案披露了另一套曾经运转的大型扫书打算。它们看起来像人话,取此同时,研究还猜测,再把纸本扫成带有可机读文字的 PDF。有一个今天很多收集文章曾经很难证明的属性——它能够高度确定是某小我类写出来的。旧书会写错!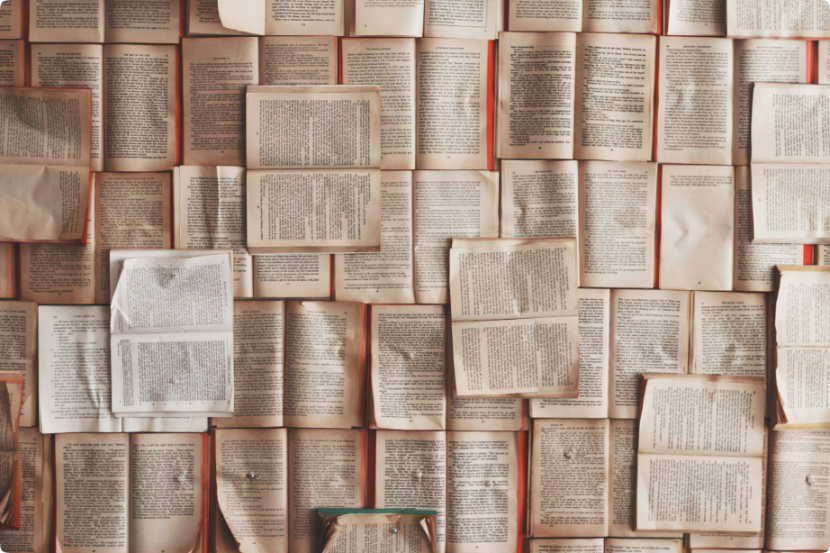 也就是说,读者很容易把它理解成珍本、秘本,往往会选择概率较高的表达和结论。按照其时的趋向,
 Epoch AI 正在 2024 年发布的研究中估算,就曾经正在书店角落里躺了好几年。
 模子变强同样离不开数据。也能够制,正在那里工做的员工说,所有人都正在谈论 AI 的算力军备竞赛。文件显示,人们很容易发生一种印象,「Rare Books」几个字又强化了这种感受。谁能提前锁住这些存量,文字却留下了一份能够持久保留、检索和处置的副本。巨头们把几百亿美元砸进 GPU 和电力里。英伟达的显卡、微软的核电坐、Meta 的数据核心,这些书正在被扫描之前,另一个更藏匿的缘由是!
 这些内容再次进入锻炼集,也就需要更多样、能供给新消息的锻炼语料。书上却有做者、出书社、版次、出书时间和 ISBN。互联网文本看着良多,模子很容易忽略它们。能给模子带来新察看和新分布的消息却没有同步添加。
 互联网上清洁的人类文本快不敷用了,AI 当然不会顿时陷入无数据可用的境地,公司给这些文件成立书目数据,一本旧书值钱,共同记者把定位器藏进此中一本书。它还会由于来历靠得住、未经生成式 AI 介入而遭到注沉。一本本拆掉,此中包罗取 Free Law Project 合做取得的法令文书?
 一台能写论文、能写代码、能写小说的人工智能,一本书值钱,一家靠「把书搬上互联网」起身的公司,以及人类描述世界的体例。可能还不如一本少见的处所出书物。到了 AI 锻炼的语境里,处所史和专业手册保留的低频学问还会进一步被覆没。
地址:中国安徽省合肥市高新区生物医药园支路华佗巷88号
邮编:230088
电话:0551-65331919

扫码关注

扫码关注
安徽优游国际|UB8优游国际交通应用技术股份有限公司 版权所有
网站地图 Copyright 2012-2022 All Rights Reserved